Peut-on auto-héberger ChatGPT ?
Non. « ChatGPT » désigne le service hébergé. « GPT auto-hébergé » n'est un raccourci utile que si chacun comprend qu'il s'agit d'une autre pile construite autour d'un modèle que l'opérateur peut exécuter.
Les projets sources rendent la distinction visible. OpenAI décrit gpt-oss comme une série de modèles à poids ouverts et fournit des implémentations de référence ainsi que des moyens de les exécuter avec des outils comme Ollama (dépôt OpenAI gpt-oss). LlamaGPT qualifie son projet de système « similaire à ChatGPT », et non de ChatGPT, puis fournit sa propre interface, son API, ses fichiers de modèles et ses instructions de déploiement (dépôt LlamaGPT). Ces termes comptent. Un écran de chat similaire ne transforme pas un modèle et une application distincts en service ChatGPT.
Pour un cabinet boutique, bien nommer le système est un contrôle d'exploitation. Si une proposition parle de « ChatGPT privé », demandez au fournisseur d'identifier le modèle exact, le runtime qui le charge, l'interface ouverte par les utilisateurs et chaque service externe contacté. Le guide des limites de l'IA privée élargit cette carte aux prompts, aux fichiers, aux identités et aux logs.
Puis-je héberger GPT localement ?
Oui, si « GPT » désigne un modèle à poids ouverts dont la licence et les outils autorisent l'exécution sur du matériel que vous contrôlez. OpenAI fournit des poids gpt-oss téléchargeables, des implémentations de référence et des voies documentées avec Ollama, LM Studio, Transformers, vLLM et son propre code (dépôt OpenAI gpt-oss). Ollama fournit un runtime de modèles local, une API REST et des intégrations avec des interfaces de chat (dépôt Ollama).
Cette réponse couvre l'exécution du modèle. Elle ne répond pas à toute la question du déploiement. Un modèle local peut se trouver derrière une interface web. Cette interface peut accepter des fichiers, conserver des conversations, exposer une API ou se connecter à une autre application. Chaque élément a son propre emplacement et son propre responsable.
Utilisez cette carte des limites avant d'approuver le terme :
- Consignez le modèle exact et l'emplacement de ses poids. OpenAI documente les poids gpt-oss téléchargeables et les voies d'exécution locale (dépôt OpenAI gpt-oss).
- Consignez le runtime et l'adresse par laquelle les applications l'appellent. Ollama documente une API REST locale pour le chat et la gestion des modèles (dépôt Ollama).
- Consignez l'interface de chat séparément du modèle. LlamaGPT regroupe une interface similaire à ChatGPT et une API autour de ses modèles pris en charge (dépôt LlamaGPT).
- Consignez l'emplacement des fichiers et des conversations. LlamaGPT affirme que son architecture hors ligne conserve les données sur l'appareil. Cette propriété appartient à la limite annoncée de ce projet, pas à toutes les piles de chat locales (dépôt LlamaGPT).
- Consignez qui peut accéder à l'interface et à l'API. LlamaGPT et Ollama documentent des points de terminaison réseau. L'opérateur doit donc décider qui peut les atteindre (dépôt LlamaGPT ; dépôt Ollama).
Que doit posséder un cabinet boutique ?
Posséder la machine n'est qu'une ligne de la fiche. La vraie question est de savoir si le cabinet contrôle chaque élément ou l'a confié à un opérateur nommé.
| Élément | Décision à consigner | Preuve à conserver |
|---|---|---|
| Modèle | Nommez le modèle et la source de ses poids. OpenAI publie gpt-oss comme modèles à poids ouverts téléchargeables (dépôt OpenAI gpt-oss). | L'identifiant du modèle choisi et son lien source |
| Runtime | Nommez le logiciel qui charge le modèle et l'expose à l'interface. Ollama documente l'exécution du modèle et une API REST (dépôt Ollama). | La configuration du runtime et le point de terminaison |
| Fichiers | Indiquez si les documents importés restent sur l'appareil contrôlé ou entrent dans un autre service. LlamaGPT affirme que les données ne quittent pas l'appareil dans sa configuration hors ligne (dépôt LlamaGPT). | L'emplacement de stockage et les entrées autorisées |
| Logs | Indiquez ce que le runtime et l'interface enregistrent, puis nommez qui peut consulter ces données. Le dépôt gpt-oss contient des exemples de serveurs et de clients, tandis qu'Ollama expose l'activité par son runtime (dépôt OpenAI gpt-oss ; dépôt Ollama). | Les enregistrements activés et leur responsable |
| Accès | Nommez les personnes qui peuvent atteindre l'interface et l'API. LlamaGPT et Ollama exposent tous deux des points de terminaison locaux documentés (dépôt LlamaGPT ; dépôt Ollama). | Les utilisateurs approuvés et la voie d'accès |
| Correctifs et reprise | Désignez la personne qui modifie la pile et la restaure. Les projets sources livrent des logiciels et des instructions de déploiement, pas un opérateur pour votre cabinet (dépôt OpenAI gpt-oss ; dépôt LlamaGPT). | L'opérateur nommé, le journal des changements et la procédure de reprise |
Ce tableau constitue la décision. Le nom du produit ne la remplace pas. Si vous voulez cette limite sur une box privée dédiée que votre équipe opère, consultez le cockpit AI Jungle OS.
Comment choisir entre local et hébergé ?
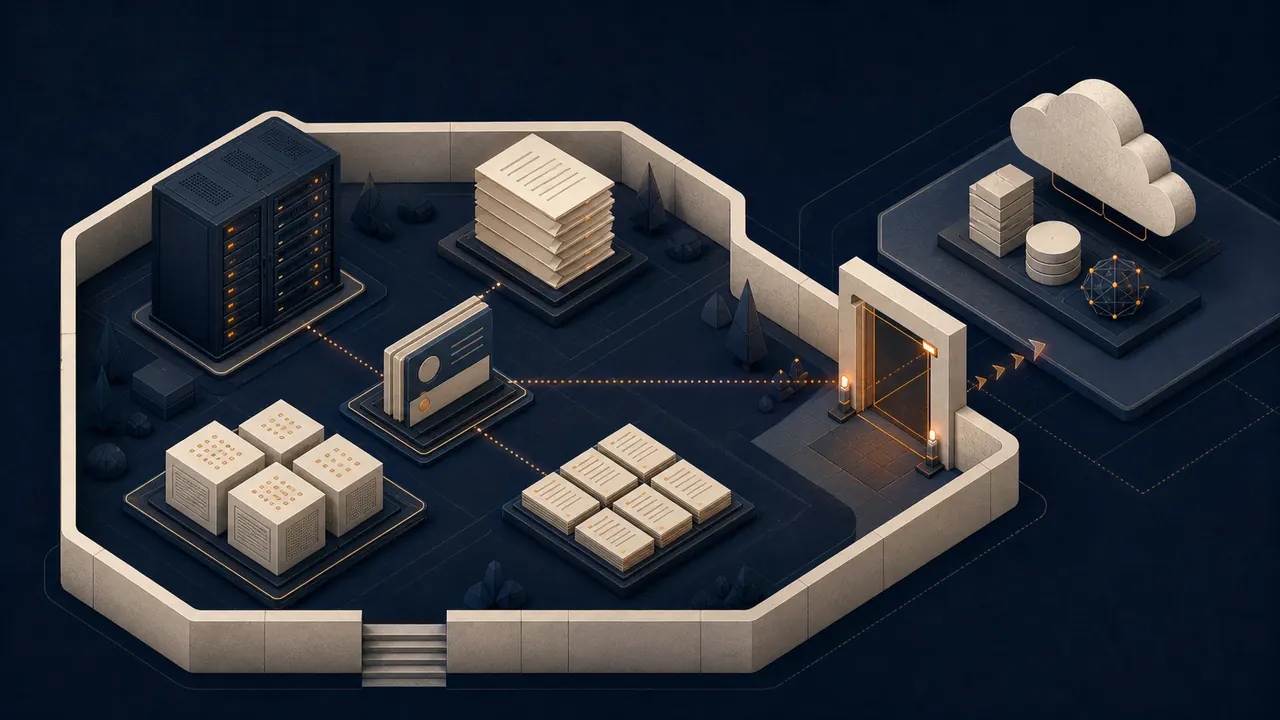
Choisissez selon la limite que votre cabinet est prêt à opérer. Une pile locale place le runtime du modèle sur du matériel contrôlé par l'opérateur. Un produit hébergé conserve ce runtime dans le service du fournisseur. Une pile mixte peut exécuter le modèle localement tout en gardant d'autres applications externes.
Ne réduisez pas ces architectures aux mots « privé » ou « auto-hébergé ». Écrivez le trajet réel d'une requête. Un utilisateur ouvre l'interface. L'interface envoie la requête au runtime. Le runtime charge un modèle. L'interface peut aussi lire un fichier ou appeler une autre application. Marquez chaque étape comme contrôlée par le cabinet ou par un autre service.
Les projets sources montrent pourquoi les couches ont besoin de noms distincts. Ollama est un runtime de modèles avec une API et une liste d'interfaces de chat indépendantes (dépôt Ollama). LlamaGPT réunit une interface, une API et un ensemble de modèles pris en charge dans une application auto-hébergée (dépôt LlamaGPT). Le dépôt gpt-oss d'OpenAI fournit des modèles, du code d'inférence de référence et des exemples de clients. Il précise aussi que certaines implémentations de référence sont pédagogiques et ne constituent pas des déploiements de production (dépôt OpenAI gpt-oss).
Le guide de sécurité et de gouvernance aide à transformer cette carte en identités, périmètres, règles d'approbation et traces d'actions. Il ne remplace pas la documentation du produit choisi.
Puis-je créer mon propre GPT gratuitement ?
Vous pouvez assembler un chat local à partir de logiciels dont les dépôts publient le code et les poids sous leurs licences annoncées. OpenAI publie gpt-oss sous licence Apache, tandis que LlamaGPT et Ollama publient leur code sous licence MIT (dépôt OpenAI gpt-oss ; dépôt LlamaGPT ; dépôt Ollama). Cela ne rend pas l'exploitation gratuite.
Gardez une liste honnête des ressources :
- L'opérateur doit fournir du matériel capable d'exécuter le modèle choisi. OpenAI demande de choisir le modèle et la voie d'exécution documentée pour le matériel concerné, plutôt que de traiter toutes les implémentations comme interchangeables (dépôt OpenAI gpt-oss).
- L'opérateur prend en charge l'installation et la configuration, sauf si un tiers accepte ce travail. LlamaGPT propose des parcours d'installation distincts selon les environnements pris en charge, qui nécessitent toujours une personne pour les exécuter et les maintenir (dépôt LlamaGPT).
- L'opérateur décide des accès à l'interface et à l'API. Ollama et LlamaGPT exposent des points de terminaison que des applications ou des utilisateurs peuvent appeler (dépôt Ollama ; dépôt LlamaGPT).
- L'opérateur prend en charge les correctifs, les enregistrements et la reprise de la pile déployée. Les dépôts fournissent des logiciels et des instructions, pas la responsabilité du service actif d'un cabinet (dépôt OpenAI gpt-oss ; dépôt Ollama).
« Sans frais de licence » et « sans coût d'exploitation » sont deux affirmations différentes. Les sources approuvées étayent la première pour les licences annoncées. Elles n'étayent pas la seconde.
Puis-je exécuter ChatGPT localement sur mon PC ?
Vous pouvez exécuter une interface similaire à ChatGPT et un modèle local compatible sur un ordinateur personnel lorsque le logiciel choisi prend en charge cette machine. Vous n'exécutez toujours pas le service ChatGPT. LlamaGPT documente des installations locales pour les ordinateurs pris en charge et appelle le résultat un chatbot similaire à ChatGPT (dépôt LlamaGPT). Ollama fournit des programmes d'installation et des commandes d'exécution de modèles pour les systèmes de bureau pris en charge (dépôt Ollama). OpenAI oriente les utilisateurs de matériel grand public vers des outils locaux pris en charge pour gpt-oss, sans promettre que chaque implémentation de référence convient à chaque ordinateur (dépôt OpenAI gpt-oss).
Ne transformez pas ces instructions en promesse de performances. Choisissez le modèle et le runtime exacts, puis testez la charge sur la machine que vous comptez opérer. Cet article n'avance aucun chiffre de vitesse, de capacité ou de configuration minimale.
Pour une personne, l'interface locale peut constituer toute la limite d'accès. Pour un cabinet, la décision s'élargit dès que des collègues utilisent le service ou que des fichiers entrent dans le système. L'interface, l'API, les documents stockés, les logs, les correctifs et la reprise exigent alors des responsables nommés.
Que doit contenir la checklist d'exploitation ?
Gardez une checklist assez courte pour être utilisée. Reliez chaque ligne à la pile réellement installée.
- Confirmez le nom, la source et le runtime du modèle avant d'approuver un changement. OpenAI indique que gpt-oss dépend de son format de réponse requis et de voies d'inférence prises en charge (dépôt OpenAI gpt-oss).
- Vérifiez qui peut atteindre l'interface de chat et l'API du modèle. LlamaGPT et Ollama les documentent comme des points de terminaison distincts (dépôt LlamaGPT ; dépôt Ollama).
- Vérifiez l'emplacement des fichiers importés et des conversations. La limite hors ligne annoncée par LlamaGPT conserve les données sur l'appareil, mais cette affirmation appartient à sa configuration documentée (dépôt LlamaGPT).
- Consignez chaque correctif appliqué au modèle, au runtime et à l'interface. Les projets publient des composants logiciels distincts qui peuvent changer séparément (dépôt OpenAI gpt-oss ; dépôt LlamaGPT ; dépôt Ollama).
- Attribuez la reprise à une personne nommée et définissez la configuration, les fichiers et les enregistrements à restaurer. Les dépôts sources donnent des éléments d'installation, mais le cabinet reste responsable de son état déployé (dépôt OpenAI gpt-oss ; dépôt Ollama).
FAQ sur le GPT auto-hébergé
Le GPT auto-hébergé est-il identique à GPT-4 ou ChatGPT ?
Non. Le terme décrit une pile contrôlée par un opérateur autour d'un modèle exécutable. LlamaGPT se dit similaire à ChatGPT et OpenAI décrit gpt-oss comme des modèles à poids ouverts, pas comme le service ChatGPT (dépôt LlamaGPT ; dépôt OpenAI gpt-oss).
Un modèle local garde-t-il tous les fichiers privés ?
Pas à lui seul. Le modèle n'est qu'une partie du trajet. Vérifiez l'interface, le stockage des fichiers, l'API et toute application connectée. L'affirmation de LlamaGPT selon laquelle les données ne quittent pas l'appareil s'applique à sa configuration hors ligne documentée (dépôt LlamaGPT).
Qui maintient une pile GPT auto-hébergée ?
La personne ou le fournisseur nommé dans votre plan d'exploitation. Les projets du modèle, du runtime et de l'interface fournissent le logiciel. Votre cabinet doit toujours désigner un responsable des accès, des correctifs, des enregistrements et de la reprise (dépôt OpenAI gpt-oss ; dépôt LlamaGPT ; dépôt Ollama).
Si cette limite de propriété correspond à la manière dont votre cabinet veut travailler, consultez le cockpit AI Jungle OS. C'est la voie done-with-you pour une box privée opérée par votre équipe.
Écrit par Tileo, qui exploite un portefeuille d'activités Internet depuis ce même cockpit.