¿Se puede autoalojar ChatGPT?
No. «ChatGPT» designa el servicio alojado. «GPT autoalojado» solo es un atajo útil cuando todos entienden que se refiere a otra pila construida alrededor de un modelo que el operador puede ejecutar.
Los proyectos fuente dejan clara la diferencia. OpenAI llama a gpt-oss una serie de modelos de pesos abiertos y aporta implementaciones de referencia y vías para ejecutar los modelos mediante herramientas como Ollama (repositorio de OpenAI gpt-oss). LlamaGPT llama a su proyecto «similar a ChatGPT», no ChatGPT, y suministra su propia interfaz, API, archivos de modelo e instrucciones de despliegue (repositorio de LlamaGPT). Esos nombres importan. Una pantalla de chat parecida no convierte un modelo y una aplicación distintos en el servicio ChatGPT.
Para una firma boutique, nombrar bien el sistema es un control operativo. Si una propuesta dice «ChatGPT privado», pide al proveedor que identifique el modelo exacto, el runtime que lo carga, la interfaz que abren los usuarios y cada servicio externo que contacta la pila. La guía de límites de IA privada amplía el mapa a prompts, archivos, identidad y registros.
¿Puedo alojar GPT localmente?
Sí, si «GPT» significa un modelo de pesos abiertos cuya licencia y herramientas permiten ejecutarlo en hardware que controlas. OpenAI ofrece pesos gpt-oss descargables, implementaciones de referencia y rutas documentadas mediante Ollama, LM Studio, Transformers, vLLM y su propio código (repositorio de OpenAI gpt-oss). Ollama proporciona un runtime local de modelos, una API REST e integraciones con interfaces de chat (repositorio de Ollama).
Esa respuesta cubre la ejecución del modelo. No resuelve toda la pregunta del despliegue. Un modelo local puede estar detrás de una interfaz web. Esa interfaz puede aceptar archivos, guardar conversaciones, exponer una API o conectarse a otra aplicación. Cada parte tiene su propia ubicación y su propio responsable.
Usa este mapa de límites antes de aprobar la etiqueta:
- Registra el modelo exacto y dónde se guardan sus pesos. OpenAI documenta los pesos gpt-oss descargables y las rutas de ejecución local (repositorio de OpenAI gpt-oss).
- Registra el runtime y la dirección por la que lo llaman las aplicaciones. Ollama documenta una API REST local para el chat y la gestión de modelos (repositorio de Ollama).
- Registra la interfaz de chat por separado del modelo. LlamaGPT empaqueta una interfaz similar a ChatGPT y una API alrededor de los modelos compatibles (repositorio de LlamaGPT).
- Registra dónde viven los archivos y las conversaciones. LlamaGPT afirma que su diseño sin conexión mantiene los datos en el dispositivo. Esa propiedad corresponde al límite declarado de ese proyecto, no a todas las pilas de chat locales (repositorio de LlamaGPT).
- Registra quién puede acceder a la interfaz y a la API. LlamaGPT y Ollama documentan endpoints de red, por lo que el operador debe decidir quién puede alcanzarlos (repositorio de LlamaGPT; repositorio de Ollama).
¿Qué necesita poseer una firma boutique?
Poseer la máquina es una sola línea de la ficha. La pregunta útil es si la firma controla cada parte o la ha asignado a un operador identificado.
| Parte | Decisión que debes registrar | Evidencia que debes conservar |
|---|---|---|
| Modelo | Nombra el modelo y la fuente de sus pesos. OpenAI publica gpt-oss como modelos descargables de pesos abiertos (repositorio de OpenAI gpt-oss). | El identificador del modelo elegido y su enlace fuente |
| Runtime | Nombra el software que carga el modelo y lo expone a la interfaz. Ollama documenta la ejecución de modelos y una API REST (repositorio de Ollama). | La configuración del runtime y el endpoint |
| Archivos | Indica si el material subido permanece en el dispositivo controlado o entra en otro servicio. LlamaGPT afirma que los datos no salen del dispositivo en su configuración sin conexión (repositorio de LlamaGPT). | La ubicación de almacenamiento y las entradas permitidas |
| Registros | Indica qué registran el runtime y la interfaz, y quién puede revisarlo. El repositorio gpt-oss incluye ejemplos de servidor y cliente, mientras que Ollama expone actividad mediante su runtime (repositorio de OpenAI gpt-oss; repositorio de Ollama). | Los registros habilitados y su responsable |
| Acceso | Nombra quién puede alcanzar la interfaz y la API. LlamaGPT y Ollama exponen endpoints locales documentados (repositorio de LlamaGPT; repositorio de Ollama). | Los usuarios aprobados y la vía de acceso |
| Parches y recuperación | Asigna a la persona que cambia y restaura la pila. Los proyectos fuente entregan software e instrucciones, no un operador para tu firma (repositorio de OpenAI gpt-oss; repositorio de LlamaGPT). | El operador, el registro de cambios y el procedimiento de recuperación |
Esta tabla es la decisión. El nombre del producto no lo es. Si quieres ese límite en una caja privada dedicada que opera tu equipo, consulta la cabina AI Jungle OS.
¿Cómo debes elegir entre local y alojado?
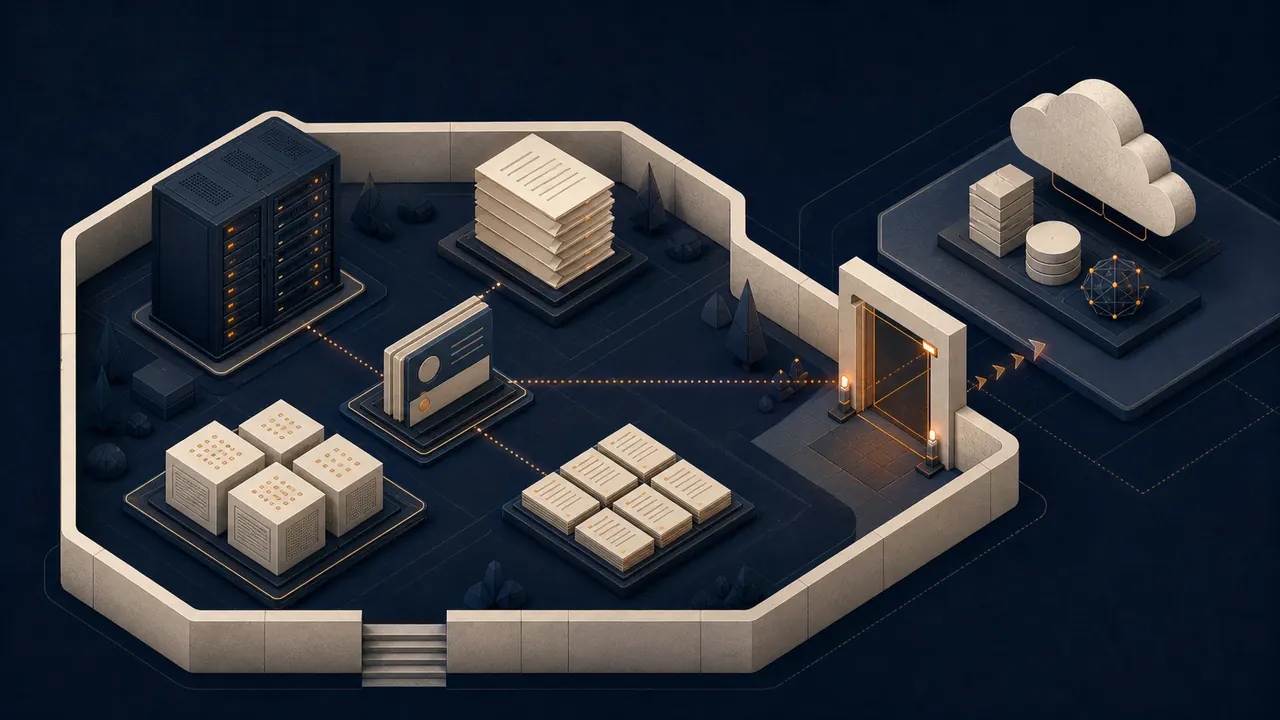
Elige según el límite que tu firma esté preparada para operar. Una pila local coloca el runtime del modelo en hardware bajo control del operador. Un producto alojado mantiene ese runtime dentro del servicio del proveedor. Una pila mixta puede ejecutar el modelo localmente mientras otras aplicaciones siguen siendo externas.
No reduzcas esas configuraciones a «privada» o «autoalojada». Escribe la ruta real de una solicitud. Un usuario abre la interfaz. La interfaz envía la solicitud a un runtime. El runtime carga un modelo. La interfaz también puede leer un archivo o llamar a otra aplicación. Marca cada paso como controlado por la firma o por otro servicio.
Los proyectos fuente muestran por qué las capas necesitan nombres distintos. Ollama es un runtime de modelos con API y una lista de interfaces de chat independientes (repositorio de Ollama). LlamaGPT reúne una interfaz, una API y un conjunto de modelos compatibles en una aplicación autoalojada (repositorio de LlamaGPT). El repositorio gpt-oss de OpenAI suministra modelos, código de inferencia de referencia y clientes de ejemplo, y advierte que algunas implementaciones de referencia son educativas y no despliegues de producción (repositorio de OpenAI gpt-oss).
La guía de seguridad y gobierno ayuda a convertir ese mapa en identidades, ámbitos, reglas de aprobación y registros de acciones. No sustituye la documentación del producto que elijas.
¿Puedo crear mi propio GPT gratis?
Puedes montar un chat local con software cuyos repositorios publican código y pesos bajo las licencias declaradas. OpenAI publica gpt-oss bajo licencia Apache, mientras que LlamaGPT y Ollama publican su código bajo licencia MIT (repositorio de OpenAI gpt-oss; repositorio de LlamaGPT; repositorio de Ollama). Eso no hace gratuita la operación.
Mantén una lista honesta de recursos:
- El operador debe aportar hardware capaz de ejecutar el modelo elegido. OpenAI indica que se debe elegir el modelo y la ruta de ejecución documentada para el hardware en cuestión, sin tratar todas las implementaciones como intercambiables (repositorio de OpenAI gpt-oss).
- El operador se ocupa de la instalación y la configuración salvo que otra parte acepte ese trabajo. LlamaGPT ofrece rutas de instalación distintas para los entornos compatibles, que aun así requieren a alguien que las ejecute y mantenga (repositorio de LlamaGPT).
- El operador decide el acceso a la interfaz y a la API. Ollama y LlamaGPT exponen endpoints a los que pueden llamar aplicaciones o usuarios (repositorio de Ollama; repositorio de LlamaGPT).
- El operador se ocupa de los parches, los registros y la recuperación de la pila desplegada. Los repositorios proporcionan software e instrucciones, no la responsabilidad del servicio activo de una firma (repositorio de OpenAI gpt-oss; repositorio de Ollama).
«Sin coste de licencia» y «sin coste operativo» son afirmaciones distintas. Las fuentes aprobadas respaldan la primera para sus licencias declaradas. No respaldan la segunda.
¿Puedo ejecutar ChatGPT localmente en mi PC?
Puedes ejecutar una interfaz similar a ChatGPT y un modelo local compatible en un ordenador personal cuando el software elegido admita esa máquina. Sigues sin ejecutar el servicio ChatGPT. LlamaGPT documenta rutas de instalación local para ordenadores compatibles y llama al resultado chatbot similar a ChatGPT (repositorio de LlamaGPT). Ollama ofrece instaladores y comandos de ejecución de modelos para sistemas de escritorio compatibles (repositorio de Ollama). OpenAI dirige a quienes usan hardware de consumo hacia herramientas locales compatibles para gpt-oss, sin prometer que cada implementación de referencia sirva para cada ordenador (repositorio de OpenAI gpt-oss).
No conviertas esas instrucciones en una promesa de rendimiento. Elige el modelo y el runtime exactos y prueba la carga en la máquina que vas a operar. Este artículo no afirma una velocidad, capacidad o requisito mínimo de hardware.
Para una persona, una interfaz local puede constituir todo el límite de acceso. Para una firma, la decisión crece cuando los compañeros necesitan el servicio o entran archivos en el sistema. La interfaz, la API, el material almacenado, los registros, los parches y la recuperación necesitan entonces responsables identificados.
¿Qué debe incluir la lista operativa?
Mantén la lista lo bastante corta para usarla. Vincula cada punto a la pila realmente instalada.
- Confirma el nombre, la fuente y el runtime del modelo antes de aprobar un cambio. OpenAI documenta que gpt-oss depende de su formato de respuesta exigido y de rutas de inferencia compatibles (repositorio de OpenAI gpt-oss).
- Revisa quién puede alcanzar tanto la interfaz de chat como la API del modelo. LlamaGPT y Ollama las documentan como endpoints distintos (repositorio de LlamaGPT; repositorio de Ollama).
- Comprueba dónde se guardan los archivos subidos y las conversaciones. El límite sin conexión declarado por LlamaGPT mantiene los datos en el dispositivo, pero esa afirmación corresponde a su configuración documentada (repositorio de LlamaGPT).
- Registra cada parche del modelo, el runtime y la interfaz. Los proyectos publican componentes distintos que pueden cambiar por separado (repositorio de OpenAI gpt-oss; repositorio de LlamaGPT; repositorio de Ollama).
- Asigna la recuperación a una persona y define qué configuración, archivos y registros deben volver. Los repositorios fuente aportan material de instalación, pero la firma sigue siendo responsable del estado desplegado (repositorio de OpenAI gpt-oss; repositorio de Ollama).
Preguntas frecuentes sobre el GPT autoalojado
¿Es lo mismo un GPT autoalojado que GPT-4 o ChatGPT?
No. La etiqueta describe una pila controlada por un operador alrededor de un modelo ejecutable. LlamaGPT se denomina similar a ChatGPT y OpenAI describe gpt-oss como modelos de pesos abiertos, no como el servicio ChatGPT (repositorio de LlamaGPT; repositorio de OpenAI gpt-oss).
¿Mantiene privados todos los archivos un modelo local?
No por sí solo. El modelo es una parte de la ruta. Comprueba la interfaz, el almacenamiento, la API y cualquier otra aplicación conectada. La afirmación de LlamaGPT de que los datos no salen del dispositivo se aplica a su configuración sin conexión documentada (repositorio de LlamaGPT).
¿Quién mantiene una pila GPT autoalojada?
La persona o el proveedor nombrado en tu plan operativo. Los proyectos del modelo, el runtime y la interfaz proporcionan software. Tu firma todavía necesita un responsable de acceso, parches, registros y recuperación (repositorio de OpenAI gpt-oss; repositorio de LlamaGPT; repositorio de Ollama).
Si ese límite de propiedad encaja con la forma de trabajar de tu firma, consulta la cabina AI Jungle OS. Es la vía done-with-you para una caja privada que opera tu equipo.
Escrito por Tileo, quien opera una cartera de negocios de Internet desde esta misma cabina.